互斥和獨立事件
互斥事件指的是兩個或多個事件不可能同時發生的情況。
如果事件 A 發生,那麼事件 B 就不可能發生,且反之亦然。
數學上,兩個互斥事件 A 和 B 的概率滿足 P(A ∩ B) = 0,即它們的交集為空集。
例如,擲一個骰子,事件 A 是出現奇數點數,事件 B 是出現偶數點數。
由於奇數和偶數是互斥的,因此在一次擲骰子的結果中,不能同時出現奇數和偶數。
因此,事件 A 和事件 B 是互斥事件。
獨立事件指的是兩個或多個事件的發生與其他事件的發生無關。
如果事件 A 發生與否不會影響事件 B 發生的概率。
數學上,獨立事件 A 和 B 滿足乘法規則: P(A ∩ B) = P(A) * P(B)。
例如,考慮一個從一副撲克牌中抽一張牌、放回並洗牌後再抽一張的實驗,事件 A 是第一張牌是紅心❤️,事件 B 是第二張牌是黑桃 ♠️。
由於第一張牌已經放回,第一張牌是紅心不會影響第二張牌是黑桃的概率(都是 1/4),反之亦然。
P(A ∩ B) = 1/4 × 1/4 = 1/16 = P(A) × P(B),因此事件 A 和事件 B 是獨立事件。
如果抽完不放回,兩者就不是獨立事件:第一張是紅心時,剩下 51 張中有 13 張黑桃,第二張是黑桃的機率變成 13/51,而不是 1/4。
骰1個骰子的期望值怎麼算?
期望值是 相加所有(出現的值*出現的機率)
期望值 = (1 × 1/6) + (2 × 1/6) + (3 × 1/6) + (4 × 1/6) + (5 × 1/6) + (6 × 1/6) = 3.5
骰的次數越多總平均會接近期望值
期望值 3.5 表示在長期多次擲骰子的情況下,
擲骰子的平均結果將趨近於 3.5。
三顆骰子,一奇數二偶數的機率
現在,我們需要確定符合要求的組合數。我們希望有一顆骰子是奇數,而另外兩顆骰子是偶數。這種情況下,有三種可能性:
- 奇數-偶數-偶數
- 偶數-奇數-偶數
- 偶數-偶數-奇數
對於每種可能性,我們需要計算出每顆骰子的組合數。奇數有三種選擇(1、3、5),而偶數有三種選擇(2、4、6)。
因此,根據組合計數的原理,我們可以計算滿足要求的組合數為:
- 3 (奇數選擇) × 3 (偶數選擇) × 3 (偶數選擇) = 27
- 3 (偶數選擇) × 3 (奇數選擇) × 3 (偶數選擇) = 27
- 3 (偶數選擇) × 3 (偶數選擇) × 3 (奇數選擇) = 27
接下來,我們需要考慮所有可能的組合數。
每顆骰子有六個點數,所以總共有 6 × 6 × 6 = 216 種組合。
最後,我們可以計算機率,即符合要求的組合數除以所有可能的組合數:
機率 = 符合要求的組合數 / 所有可能的組合數 = (27+27+27) / 216 = 3/8
有五個銅板,有四個正面的機率是多少?
我們有五個銅板,每個銅板都有兩種可能的結果:正面和反面。
因此,總共有 2^5 = 32 種不同的組合。
現在我們要計算有四個正面的組合數。在五個銅板中,選擇四個銅板出現正面,剩下的一個銅板出現反面。這種情況有 C(5, 4) = 5 種組合。
每個符合條件的組合中,有四個銅板出現正面,一個銅板出現反面。
也就是 組合數 × (單個銅板出現正面的機率)^4 × (單個銅板出現反面的機率)^1
所以,機率 = C(5, 4) × p^4 × (1-p)^1 = 5 × (1/2)^4 × (1/2)^1 = 5/32
二項式分布
上面銅板的算法可以推廣:只要每次試驗互相獨立、成功機率固定是 ,做 次總共成功幾次(記作 )就是一個二項式分布,記作 。剛好成功 次的機率是
是「哪 次成功」的組合數,後面是其中任一種排法發生的機率。五個銅板就是 、、 的特例。
下面用「擲一顆骰子,擲出 6 點算成功」當例子,也就是 。
至少一次:用補集
「至少成功一次」要把 全部加起來,很麻煩。反過來算比較快:先求一次都沒成功的機率 ,再用 1 減掉。
這正是機率論史上有名的德·梅雷問題(Chevalier de Méré’s problem):擲一顆骰子 4 次,至少出現一次 6 點的機率是 ;擲兩顆骰子 24 次,至少出現一次雙 6 的機率卻只有 。
同樣是擲 4 次,剛好一次 6 點的機率是 ,比「至少一次」少了一截,差的就是出現兩次以上的情況。「至少」和「剛好」問的是不同的事,別混在一起。
平均 1/p 次,不是保證 1/p 次
成功機率是 時,平均要試 次才會第一次成功(這是幾何分布的期望值)。但平均不代表保證:擲 6 次骰子,一次 6 點都沒出現的機率還有 。
而且只要 , 越小,這個機率就越接近 。例如 、 時是 。這是因為
要做幾次才有把握
反過來問:「想要有把握 至少成功一次,得做幾次?」把 移項、兩邊取對數( 是負數,不等號要反向),再無條件進位:
以擲骰子為例,想有九成把握()擲出 6 點要 13 次;九成九要 26 次。分子從 變成 剛好是兩倍,所以次數也大約翻倍:越接近「確定」,代價就越高。
如果要的是「至少成功 2 次以上」, 是好幾項的和,沒辦法像上面一樣直接解出 。不過 會隨 遞增,所以可以用數值方法找出第一個讓 的 。
期望值可以直接相加
期望值有一個很好用的性質:線性。不管各個隨機變數之間獨不獨立,和的期望值都等於期望值的和:
二項式分布的期望值就是這樣來的: 次試驗,每次平均貢獻 次成功,加起來 。
期望值不是單次實驗會得到的結果。擲 4 次骰子,6 點出現次數的期望值是 ,但沒有人能擲出 2/3 次 6 點;它的意思是同樣的實驗重複很多很多輪後,平均每輪大約 2/3 次。實際每一輪只會是 0、1、2 這樣的整數。
同時看多個結果:多項分布
二項式分布只把結果分成「成功」與「失敗」兩類,一次只能回答「某一種結果出現了幾次」。如果想同時知道「擲 次骰子,1 點出現幾次、2 點又出現幾次」,就得換成多項分布:
算出來是一張多維的聯合機率表,比二項式分布難讀得多。
期望值就沒有這個麻煩。每種結果的機率 乘上它的值 ,加總後再乘上次數:
例如擲 次骰子的點數總和,期望值就是 ,正是上面 骰1個骰子的期望值 乘上 。線性性質保證這條式子永遠成立,不需要管各種結果的出現次數彼此有沒有關聯。順帶一提,同一次擲骰裡各個點數是互斥的(只會出現一種),不同次擲骰之間則是獨立的,兩個概念的差別見上方 互斥和獨立事件。
PDF 跟 CDF 是什麼
- 概率密度函數(Probability Density Function, PDF)
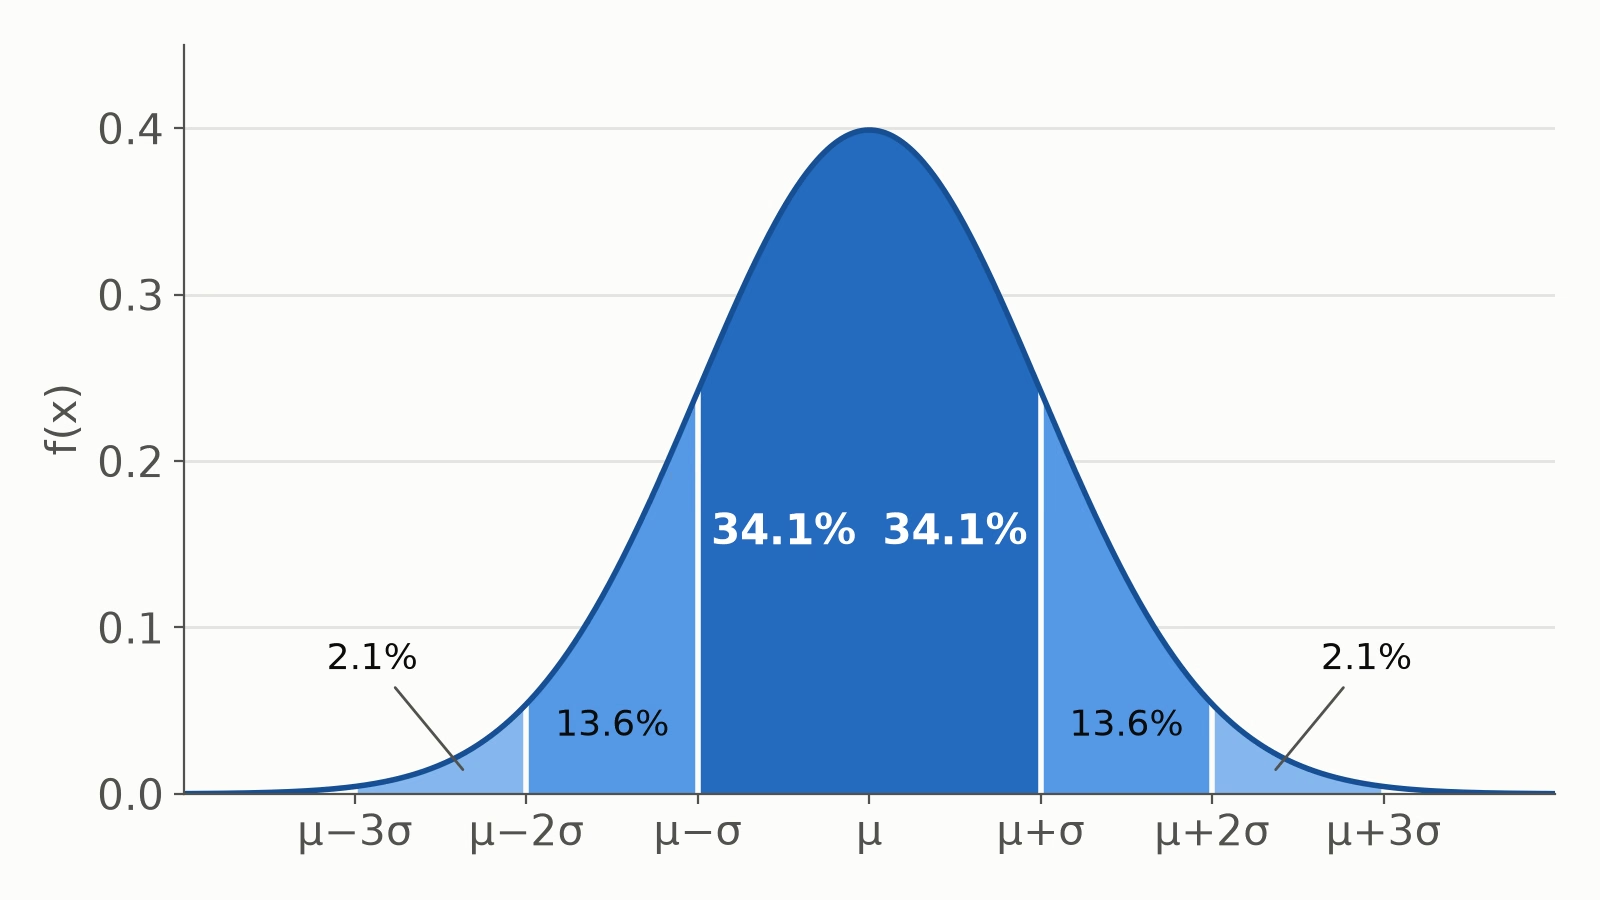
概率密度函數(PDF)用於描述連續隨機變量在不同取值點上的概率密度。
它可以看作是概率分布曲線的密度,通常是一個平滑的曲線。
PDF 的值代表了在特定取值點上的概率密度,即該點附近的概率密度值有多大。
PDF 的積分對應於在整個定義域上的概率,其積分值等於 1。
上圖是常態分佈的 PDF,曲線下某個區間的面積,就是隨機變量落在該區間的概率。
圖中每個色塊標示的是該區間的面積:落在 μ±σ 內的概率約 68.27%、μ±2σ 內約 95.45%、μ±3σ 內約 99.73%(常稱為 68-95-99.7 法則)。
- 累積分佈函數(Cumulative Distribution Function, CDF)
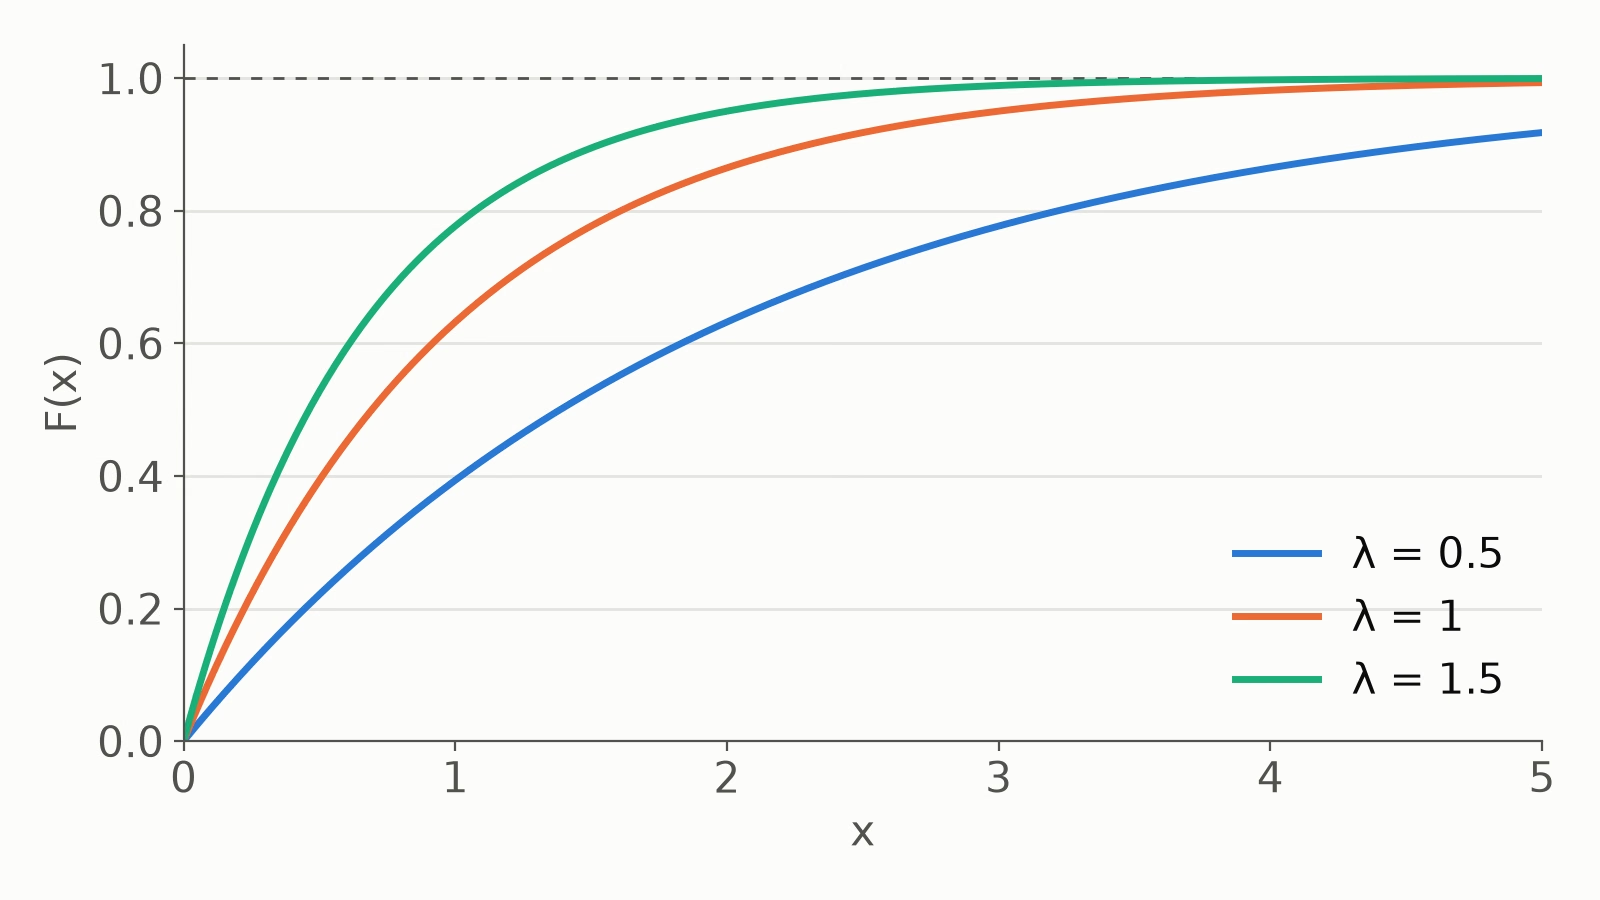
累積分佈函數(CDF)則用於描述隨機變量小於或等於給定值的概率。
它表示了隨機變量取值小於或等於某一特定值的概率。
CDF 是一個非遞減的函數,其值域在 0 到 1 之間。
CDF 的值在 x 處給出了小於或等於 x 的概率,即 F(x) = P(X ≤ x)。
上圖是指數分佈的 CDF,F(x) = 1 − e^(−λx),分別畫出 λ = 0.5、1、1.5 三種情況。
三條曲線都從 0 開始遞增,並逐漸趨近 1(虛線);λ 越大,曲線上升得越快,代表隨機變量越可能取到較小的值。
CDF 是 PDF 的積分,也就是將 PDF 曲線下的面積進行累加。
離散的情況:PMF
PDF 是給連續隨機變量用的,單一點上的機率其實是 0,只有區間才有面積。像二項式分布這種只會取整數的離散隨機變量,對應的是機率質量函數(Probability Mass Function, PMF):直接給出「剛好等於 」的機率 ,每一點都是真正的機率,全部加起來等於 1。
CDF 的定義不變,只是積分換成加總:
實際應用時,常常還會用到反方向的上側累積機率 ,例如「至少成功兩次」。三者是同一個分布的三種問法:
| 寫法 | 意思 | 名稱 |
|---|---|---|
| 剛好 次 | PMF,長條圖畫的就是它 | |
| 最多 次 | CDF | |
| 至少 次 | 上側累積機率 |
它們之間的關係是
要減掉 ,是因為「剛好 次」在左右兩邊都被算了一次。連續的情況單點機率是 0,這一項就消失了,變成熟悉的 。
什麼是Gaussian function
高斯函數(Gaussian function)是一種呈鐘形曲線的數學函數。
常態分佈(normal distribution,又稱高斯分佈)的機率密度函數就是一種高斯函數。
f(x) = A * exp(-(x - μ)² / (2σ²))
σ = 標準差
σ² = 變異數
在這個公式中,f(x) 是函數在 x 點的值,A 是幅度(或最大值),μ 是平均值,σ 是標準差,exp 是自然指數函數。
當 A = 1/(σ√(2π)) 時,曲線下的面積剛好是 1,這時 f(x) 就是常態分佈的機率密度函數(PDF)。
高斯函數通常呈現一個對稱的鐘形曲線,其峰值位於平均值 μ 的位置。標準差 σ 確定了曲線的寬度,越大曲線越寬,越小曲線越窄。
- 對稱性:曲線以平均值為中心對稱。
- 唯一峰值:曲線有一個單一的最大值。
- 平滑性:曲線連續且平滑,在平均值兩側單調遞減,沒有突變或跳躍。